Nowości
Ruch z aocr.org w analityce stron to bot. Analiza tin.computer wskazuje na stos technologiczny ByteDance
Według analizy tin.computer za wizytami z odsyłaczem aocr.org w statystykach stron stoi crawler o odcisku sieciowym zgodnym z Bytespiderem od ByteDance, choć jego operatora nie ustalono. Ten sam wzorzec widać w 8 serwisach wydawcy nowosci.ai, gdzie bot wygenerował 388 sesji, z czego 206 przypadło na 6 listopada.
Spis treści
Wizyty z odsyłaczem (referrerem) aocr.org, które od września pojawiają się w statystykach wielu stron, nie pochodzą od ludzi. Według analizy Ege Demira, opublikowanej 29 października na tin.computer, odpowiada za nie crawler, który ma odcisk sieciowy zgodny z Bytespiderem, zadeklarowanym crawlerem ByteDance, i działa z serwerów w sieci China Mobile w prowincji Shanxi. Ten sam wzorzec widać w analityce 8 serwisów wydawcy nowosci.ai.
Według tin.computer każda wizyta otwiera jedną stronę i na tym się kończy, a crawler przy każdej stronie korzysta z nowego amerykańskiego adresu proxy. Przedstawia się jako Chrome 146 na Windows 10, ma ekran 800 x 600 i strefę czasową Asia/Shanghai, a na każdej stronie czeka 28 sekund i ją przewija. Inni właściciele stron zgłaszają takie wizyty od około 24 września.
Odsyłacz jest podrobiony. Zapytania crawlera mają nagłówek Sec-Fetch-Site o wartości none, którą przeglądarka wysyła, gdy użytkownik wpisuje adres albo stronę otwiera program, a kliknięcie linku na aocr.org dałoby wartość cross-site. Adres aocr.org należy do American Osteopathic College of Radiology (AOCR). Według tin.computer organizacja nie ma z tym ruchem nic wspólnego, jej strona nie linkuje do odwiedzanych serwisów i nic nie wskazuje na włamanie. Autor prosi, by nie kontaktować się w tej sprawie z AOCR, i przyznaje, że nie znalazł powodu, dla którego crawler podaje akurat ten adres.
Co potwierdziło tin.computer
Pierwsze ustalenie dotyczy sieci: crawler wysyła pakiet TLS ClientHello innej długości niż prawdziwy Chrome w wersjach od 146 do 157, w HTTP/2 ustawia priorytet o wadze 256 zamiast 16, a w nagłówku Accept podaje format image/heif. W serwisach monitorowanych przez tin.computer od 20 września do 29 października te trzy cechy naraz miało 199 z 199 zapytań crawlera, 646 z 1 142 zapytań zadeklarowanych crawlerów Bytespider i TikTokSpider (57%) oraz 115 z 137 964 pozostałych zapytań (0,08%). Według autora Bytespider korzysta z tego stosu co najmniej od 2024 roku, ale wcześniejsze crawlery nie wysyłały odsyłacza i wyglądały jak wejścia bezpośrednie, a obecny wyróżnia się właśnie fałszywym odsyłaczem.
Drugie ustalenie pochodzi z nagrań sesji: dane o czasie ładowania zawierają pola nazwane od Forest, wewnętrznego mechanizmu ładowania zasobów ByteDance. Miało je każde nagranie wizyty crawlera i żadne z 37 nagrań prawdziwych odwiedzających, a autor ocenia, że crawler prawdopodobnie korzysta z wersji Chromium przygotowanej przez ByteDance. Trzecie dotyczy maszyn: test WebRTC na clawmessenger.com, jednym z monitorowanych serwisów, przy pierwszych siedmiu wizytach crawlera pokazał 14 adresów IPv6 z jednej podsieci /64 i 2 adresy IPv4, wszystkie w AS132510, sieci centrów danych China Mobile w prowincji Shanxi. Maszyny działają na Linuksie z chińskimi czcionkami, choć podają się za komputery z Windows.
Czego nie udowodniono
Analiza wyraźnie oddziela te ustalenia od pytania, kto prowadzi crawlera. Sieć AS132510 należy do China Mobile, a według autora korzystają z niej także inne firmy.
Nie udowodniono, kto go obsługuje. Może to być zespół ByteDance albo klient, który korzysta z technologii ByteDance. - Ege Demir, tin.computer
Jako przykład usługi ByteDance, której klient mógłby stać za crawlerem, autor podaje platformę chmurową Volcano Engine, ale nie twierdzi, że crawlera prowadzi Volcano Engine. Artykuł nie podaje też, w jakim celu crawler pobiera strony. Autor pisze, że tin.computer wysłało dowody i trzy pytania do ByteDance 29 października, a do 7 listopada tekst nie zawierał odpowiedzi. Zapowiada, że ją dopisze i poprawi fakty, jeśli ByteDance wykaże w nich błąd. Serwis tin.computer należy do firmy Emotion Machine z San Francisco, która na tej samej stronie promuje własną ofertę dotyczącą wizyt agentów AI.
Ten sam wzorzec w serwisach wydawcy
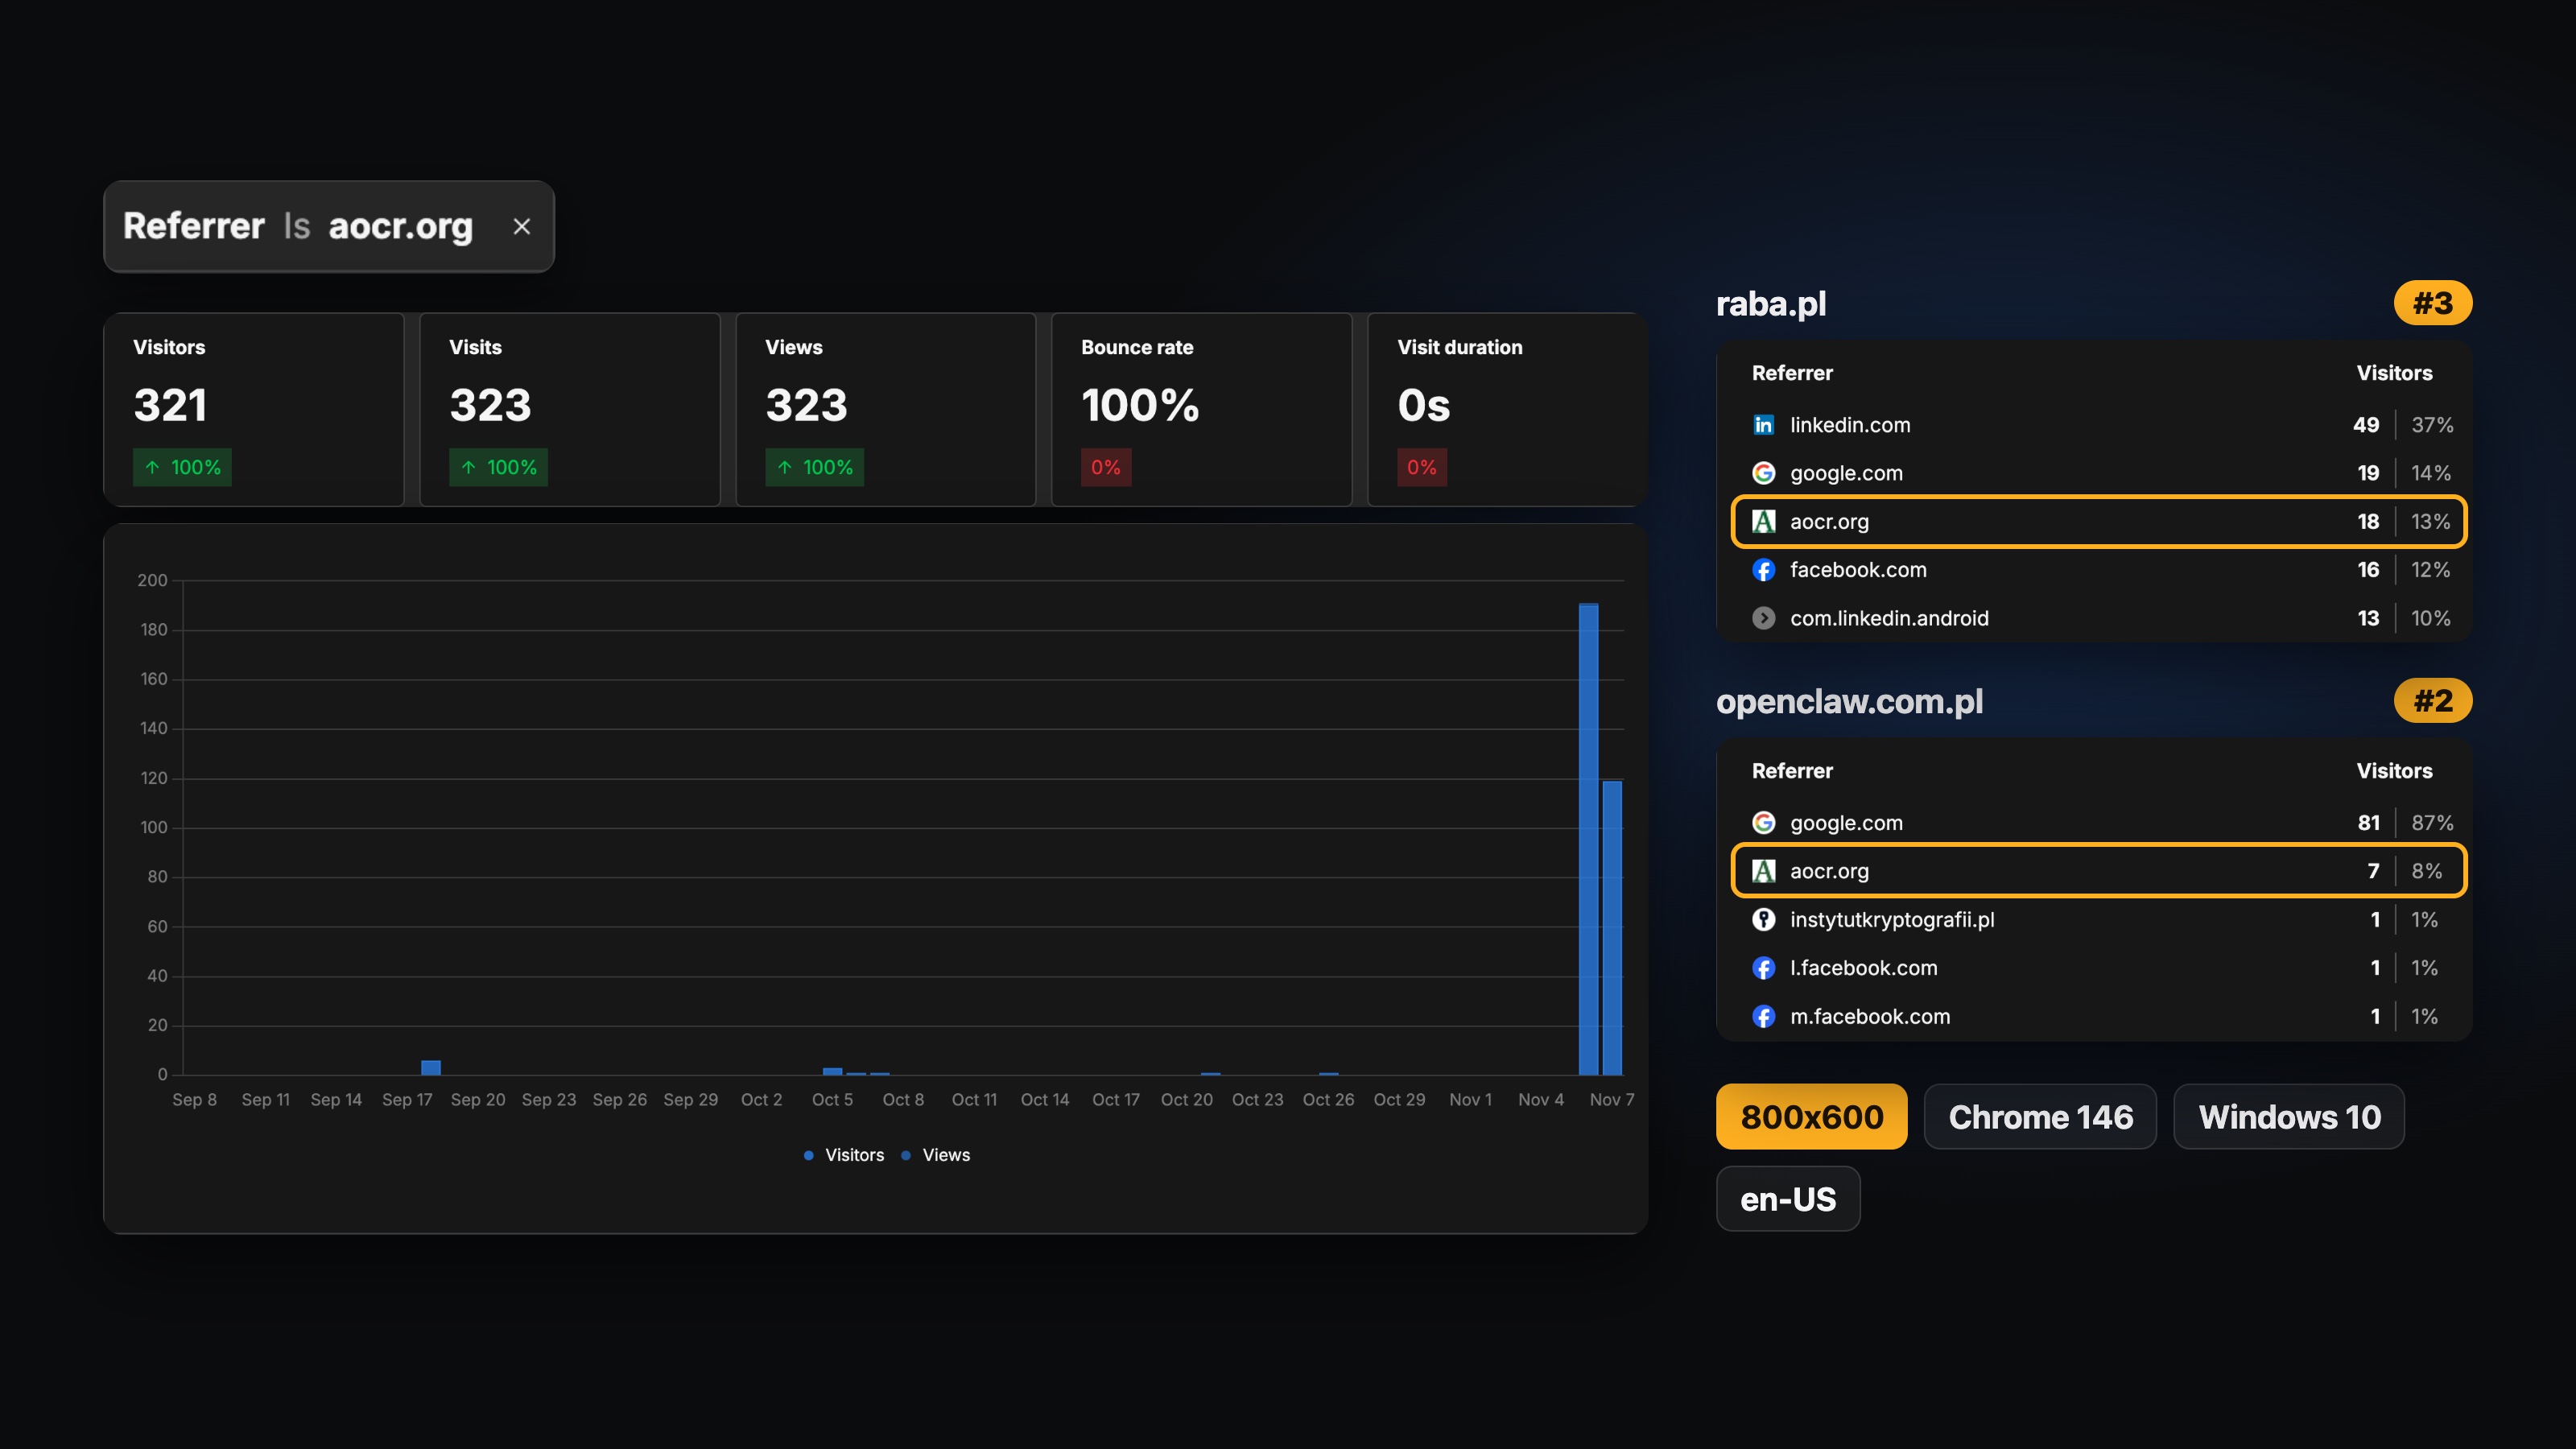
W analityce serwisów wydawcy nowosci.ai, prowadzonej w samodzielnie hostowanym Umami, do 7 listopada (13:22 UTC) zapisało się 388 sesji z odsyłaczem aocr.org w 8 serwisach. Najwięcej przypadło na największy z nich (321), dalej na nowosci.ai (37), raba.pl (18) i openclaw.com.pl (7), a w czterech mniejszych serwisach były pojedyncze sesje. W danych wydawcy pierwsze wejścia pochodzą z 18 września, a inni właściciele stron zgłaszają je według tin.computer od około 24 września. Do końca października ruch był sporadyczny, z jednym skokiem do 35 sesji 29 października, a w listopadzie gwałtownie urósł: 5 listopada było 16 sesji, 6 listopada 206, a 7 listopada do 13:22 UTC już 109.
Parametry z analityki zgadzają się z opisem tin.computer. Umami odnotował ekran 800 x 600 niemal w każdej sesji (dwie miały 600 x 800), a we wszystkich przeglądarkę Chrome, system Windows 10 i język en-US. Na jednej stronie kończyło się 375 z 389 wizyt (96%), a mediana czasu między pierwszym a ostatnim zarejestrowanym zdarzeniem wizyty wyniosła 23,6 sekundy. Trzy czwarte sesji miało adres wyjściowy w USA, pozostałe m.in. w Niemczech, Singapurze i Brazylii.
Logi serwera, który obsługuje największy z tych ośmiu serwisów i licznik Umami wszystkich serwisów wydawcy, pokazują od 13 października do 7 listopada 5 365 zapytań z odsyłaczem www.aocr.org i tym samym nagłówkiem User-Agent, który podaje tin.computer. Podrobiony odsyłacz pojawiał się w każdym zapytaniu, również o pliki CSS, JS i grafiki oraz w wywołaniach serwera analityki w innej domenie, choć zwykły Chrome podaje w nich adres odwiedzanej strony. To wskazuje, że nagłówek dodaje automat. Zapytania przyszły z 1 020 różnych adresów IP, z których tylko 7 pojawiło się więcej niż jednego dnia. Adresy należały m.in. do każdej z siedmiu sieci wymienionych w tabeli tin.computer: Datacamp/CDN77, Web2Objects, M247, Ace Data Centers, NET3, EGIHosting i FDCservers.
Skutki i co z tym zrobić
Proporcjonalnie najmocniej odczuwają to małe serwisy. Od pierwszej wizyty bota w danym serwisie jego sesje stanowiły 0,18% wszystkich sesji w największym serwisie i 0,94% na nowosci.ai, ale już 8,45% na raba.pl (18 z 213) i 16,3% na openclaw.com.pl (7 z 43). Bot zawyża też inne liczby: w największym serwisie „obejrzał” banery partnerów 924 razy, a do PostHoga, narzędzia analityki produktowej, wysłał 321 żądań ze zdarzeniami.
Najprostszy krok to filtr po odsyłaczu w narzędziu analitycznym: tin.computer zaleca wykluczenie www.aocr.org w Plausible, Umami i Fathom, a w GA4 segment bez źródła aocr.org. W Umami serwisów wydawcy domena odsyłacza zapisuje się jako aocr.org, bez www. Autor odradza blokowanie adresów IP, bo crawler przy każdej wizycie używa nowego adresu, i uprzedza, że odsyłacz może się zmienić, a odcisk sieciowy prawdopodobnie zostanie. Od 7 listopada serwer przed Umami w serwisach wydawcy nowosci.ai nie przekazuje dalej wywołań licznika z tym odsyłaczem, więc bot nie jest tam już liczony, a same strony pozostają dostępne. Szczegółowy poradnik konfiguracji filtrów publikuje osobno vibecoding.pl, serwis tego samego wydawcy.