Nowości
Claude Fable 5.2 w 41 testach: poziom wysiłku max od 3 do 10 razy droższy niż low, więcej tokenów niż w wersji 5.1
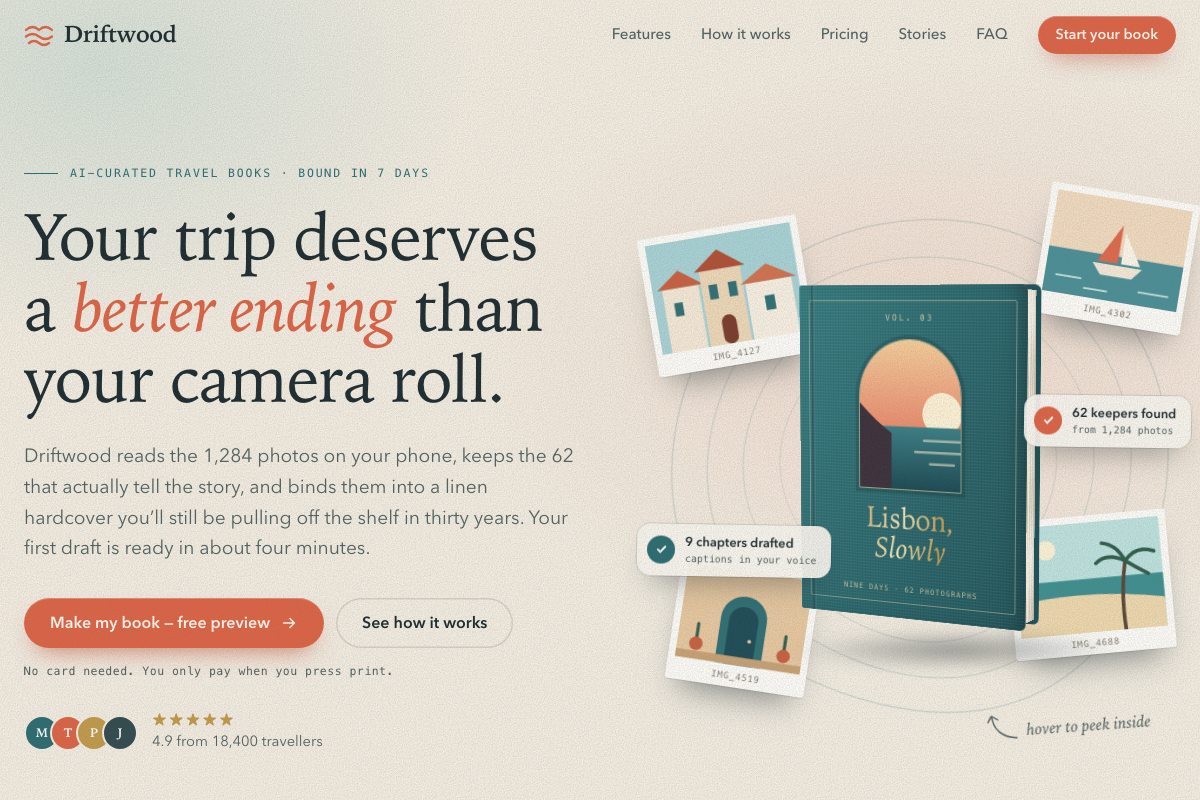
Serwis testingmodels.com, który prowadzi wydawca nowosci.ai, opublikował 41 wyników Claude Fable 5.2 na 21 zadaniach: przy tym samym zadaniu poziom wysiłku max kosztował od 3 do 10 razy więcej niż low. Na stronie docelowej, jedynym zadaniu uruchomionym na wszystkich pięciu poziomach, Fable 5.2 napisał więcej tokenów niż Fable 5.1 na każdym z nich, także na domyślnym poziomie medium.
Spis treści
Na najwyższym poziomie wysiłku, max, Claude Fable 5.2 kosztował przy tym samym zadaniu od 3 do 10 razy więcej niż na najniższym, low, a czas generowania rósł mniej więcej w tym samym tempie. Tak wynika z 41 wyników na 21 zadaniach opublikowanych na testingmodels.com. W każdym porównaniu z Fable 5.1 na tym samym zadaniu i poziomie nowa wersja napisała więcej tokenów. Serwis testingmodels.com prowadzi Patryk Raba, ten sam wydawca co nowosci.ai i vibecoding.pl, więc są to testy własne wydawcy, a nie niezależny pomiar.
O samej premierze Fable 5.2 i Mythos 5.2, ogłoszonej przez Anthropic 9 listopada, nowosci.ai informuje w osobnym artykule. W testach model dostał te same zadania co każdy model w zestawieniu testingmodels.com: od strony docelowej i gry, przez emulator CHIP-8 i symulację płynów, po arkusz kalkulacyjny i szachy. Przy każdym wyniku serwis podaje koszt, czas i liczbę tokenów, a wszystkie 41 wyników można otworzyć na testingmodels.com/pl/fable-5-2 i porównać wersje z poziomów low, medium, high i max obok siebie.
Jedno zadanie, pięć poziomów wysiłku
Najbardziej miarodajne porównanie daje zadanie Driftwood, czyli strona docelowa fikcyjnego serwisu SaaS do fotoksiążek z podróży. Między uruchomieniami zmieniał się tylko poziom wysiłku. Na low Fable 5.2 pracował 5 min 4 s i napisał 33,6 tys. tokenów, co według stawek API odpowiada 1,35 dolara. Na medium było to 2,08 dolara, 7 min 58 s i 51,5 tys. tokenów, na high 4,72 dolara, 18 min 38 s i 117,7 tys. tokenów, na xhigh 9,07 dolara, 27 min 46 s i 175,2 tys. tokenów, a na max 9,09 dolara, 37 min 34 s i 226,5 tys. tokenów. Czas i liczba tokenów rosły z każdym poziomem, a koszt od low do max wzrósł 6,7 raza.
Podobny obraz daje całe zestawienie. Średni koszt 18 wyników na poziomie low wyniósł 1,87 dolara, a średni czas 7,3 minuty. Na max, z 10 wynikami, było to 9,73 dolara i 39,3 minuty. Średnie mieszają jednak różne zadania, bo nie każde uruchomiono na każdym poziomie, więc dokładniejsze jest porównanie w obrębie jednego zadania. W takim porównaniu max kosztował od 3,1 raza więcej niż low w zadaniu digger do 10,3 raza więcej w emulatorze CHIP-8, a czas wydłużał się od 3,2 do 11,8 raza. Najtańszy był emulator CHIP-8 na low (0,91 dolara, 3 min 5 s), a najdroższy system cząsteczek na max (12,60 dolara, 46 min 9 s).
Więcej tokenów niż w Fable 5.1
Fable 5.1 również wykonał zadanie Driftwood na wszystkich pięciu poziomach. Fable 5.2 napisał więcej tokenów na każdym z nich: na low 33,6 tys. wobec 27,4 tys. (o 23% więcej), na medium 51,5 tys. wobec 26,5 tys. (o 94%), na high 117,7 tys. wobec 29,7 tys. (o 297%), na xhigh 175,2 tys. wobec 95,7 tys. (o 83%), a na max 226,5 tys. wobec 144,3 tys. (o 57%). Największy skok wypadł na high, gdzie nowa wersja wygenerowała około 4 razy więcej tokenów i pracowała 3,4 raza dłużej, 18 min 38 s zamiast 5 min 26 s. Najmniejsza różnica była na low.
Tę samą tendencję widać w innych zadaniach, w których obie wersje mają wynik na tym samym poziomie. W grze Fable 5.2 napisał 2,4 raza więcej tokenów niż Fable 5.1 na low, 1,5 raza więcej na high i 1,09 raza więcej na max, w narzędziu 1,7 raza więcej na low i 2,3 raza na high, a w dashboardzie 1,3 raza na low, 1,8 raza na high i 1,09 raza na max. Nowa wersja za każdym razem pisała więcej. W grze i dashboardzie, gdzie obie wersje mają wynik na max, właśnie na max różnica była najmniejsza. Największa wypadała zwykle na high, a w grze na low.
Na poziomie wysiłku Medium (domyślnym w aplikacjach Claude i w Claude Code) Fable 5.2 może wykonywać wymagające zadania, zużywając mniej tokenów niż Fable 5.1. - Anthropic
W zadaniu Driftwood było odwrotnie: na medium Fable 5.2 napisał o 94% więcej tokenów niż Fable 5.1. To jednak jedno zadanie i jedno uruchomienie na poziom, więc wynik jest obserwacją, a nie obaleniem deklaracji producenta, która dotyczy wymagających zadań. Pokazuje natomiast, że przy konkretnym zadaniu domyślny poziom nowej wersji może zużyć więcej tokenów niż w poprzedniej.
Za token taniej i szybciej, za zadanie niekoniecznie
Generują odpowiedzi do 30% szybciej niż Claude Fable 5.1 i Claude Mythos 5.1, a do tego są dostępne w niższej cenie: 8 dolarów za milion tokenów wejściowych i 40 dolarów za milion tokenów wyjściowych. - Anthropic
Po podzieleniu liczby tokenów przez czas generowania w zadaniu Driftwood wychodzi około 100-110 tokenów na sekundę dla Fable 5.2 i około 80-94 dla Fable 5.1, czyli w przeliczeniu na token nowa wersja była od 16% do 26% szybsza. To zgodne z zapowiedzią, choć zmierzony czas obejmuje też narzut, więc wyliczenie jest przybliżone. Szybsze tokeny nie dały jednak szybszych odpowiedzi: na każdym poziomie Fable 5.2 kończył później, bo pisał więcej. Na low skończył po 5 min 4 s wobec 4 min 53 s, a na max po 37 min 34 s wobec 30 min 16 s.
Podobnie jest z ceną. Fable 5.1 kosztował 10 dolarów za milion tokenów wejściowych i 50 dolarów za milion wyjściowych, ale nowa wersja pisze więcej, więc w zadaniu Driftwood wypadła drożej na high (4,72 wobec 2,25 dolara) i xhigh (9,07 wobec 5,58 dolara), niemal tak samo na medium (2,08 wobec 2,10 dolara), a taniej na low (1,35 wobec 2,17 dolara) i max (9,09 wobec 10,12 dolara). Kwoty zniekształca też to, że koszty Fable 5.1 zgłoszone przez CLI zawierają około 1,21 dolara kosztów po stronie wejścia na uruchomienie, wobec 0,42 dolara w Fable 5.2, dlatego testingmodels.com zaleca porównywać przede wszystkim tokeny, a nie dolary.
Jak mierzono i czego dane nie mówią
Każde zadanie na danym poziomie uruchomiono raz w Claude Code CLI, z poziomem wysiłku ustawianym dla każdego przebiegu, bez dostępu do narzędzi i bez wybierania najlepszych prób. Uruchomienia odbywały się w ramach subskrypcji, a kwoty to równowartość według cennika API, 8 dolarów za milion tokenów wejściowych i 40 dolarów za milion wyjściowych, w wysokości zgłoszonej przez CLI. Czas to rzeczywisty czas generowania, a tokeny to tokeny wyjściowe razem z tokenami rozumowania. Każdy wynik opublikowano w takiej postaci, w jakiej napisał go model, bez poprawek.
Dane mają ograniczenia. Na każde zadanie i poziom przypada jedno uruchomienie, więc nie widać rozrzutu między próbami. Zestawienie nie zawiera też oceny jakości: to, czy wyższy poziom dał lepszy wynik, czytelnik ocenia sam, otwierając wersje obok siebie. Nie wszystkie wyniki działają: emulator CHIP-8 z poziomów low i max zgłasza błąd przy ładowaniu, bo model zapisał błędnie sformatowane dane ROM w base64. Gra 3D na poziomie high została wygenerowana ponownie, bo pierwszą próbę przerwał limit użycia, zanim powstał jakikolwiek wynik, co strona zaznacza. Własne wyniki dla poziomów wysiłku podaje Anthropic: w benchmarku FrontierCode 2.0, który sprawdza, czy opiekunowie repozytoriów open source przyjęliby zmiany w kodzie zaproponowane przez model, Fable 5.2 uzyskuje według firmy 45,3% na poziomie high i 49,1% na xhigh.